簡易構成では Docker Swarm を使用せず、単一の enterprise アプリケーションノードを配置します。仮想マシンは合計 4 台です。
1 台の enterprise ノードで tier0-enterprise + EMQX を実行します。2 台のデータベースノードで PostgreSQL + TimescaleDB のプライマリ/スタンバイクラスターを構成します。1 台の Witness ノードがデータベースの監視、クォーラム判定、フェイルオーバーに参加します。
簡易構成はデプロイの複雑さを低減します。一方、アプリケーション層と EMQX は単一障害点となります。DB VIP + Witness による高可用性を維持するのはデータベース層のみです。
以下の IP アドレスは計画用のプレースホルダーです。実装前に現場の実際のネットワークに合わせて置き換えてください。
| 種別 |
名前 |
計画 IP |
説明 |
| アプリケーションノード |
ent-enterprise-01 |
10.60.10.11 |
tier0-enterprise + EMQX を実行する単一の enterprise ノード |
| 論理エンドポイント |
DB VIP |
10.60.20.10 |
現在のプライマリのみを指す共通データベースエンドポイント |
| データベースノード |
ent-db-01 |
10.60.20.11 |
PostgreSQL + TimescaleDB のプライマリ候補 |
| データベースノード |
ent-db-02 |
10.60.20.12 |
PostgreSQL + TimescaleDB のスタンバイ候補 |
| クォーラムノード |
ent-db-witness-01 |
10.60.20.13 |
repmgr witness/データベースのクォーラム監視 |
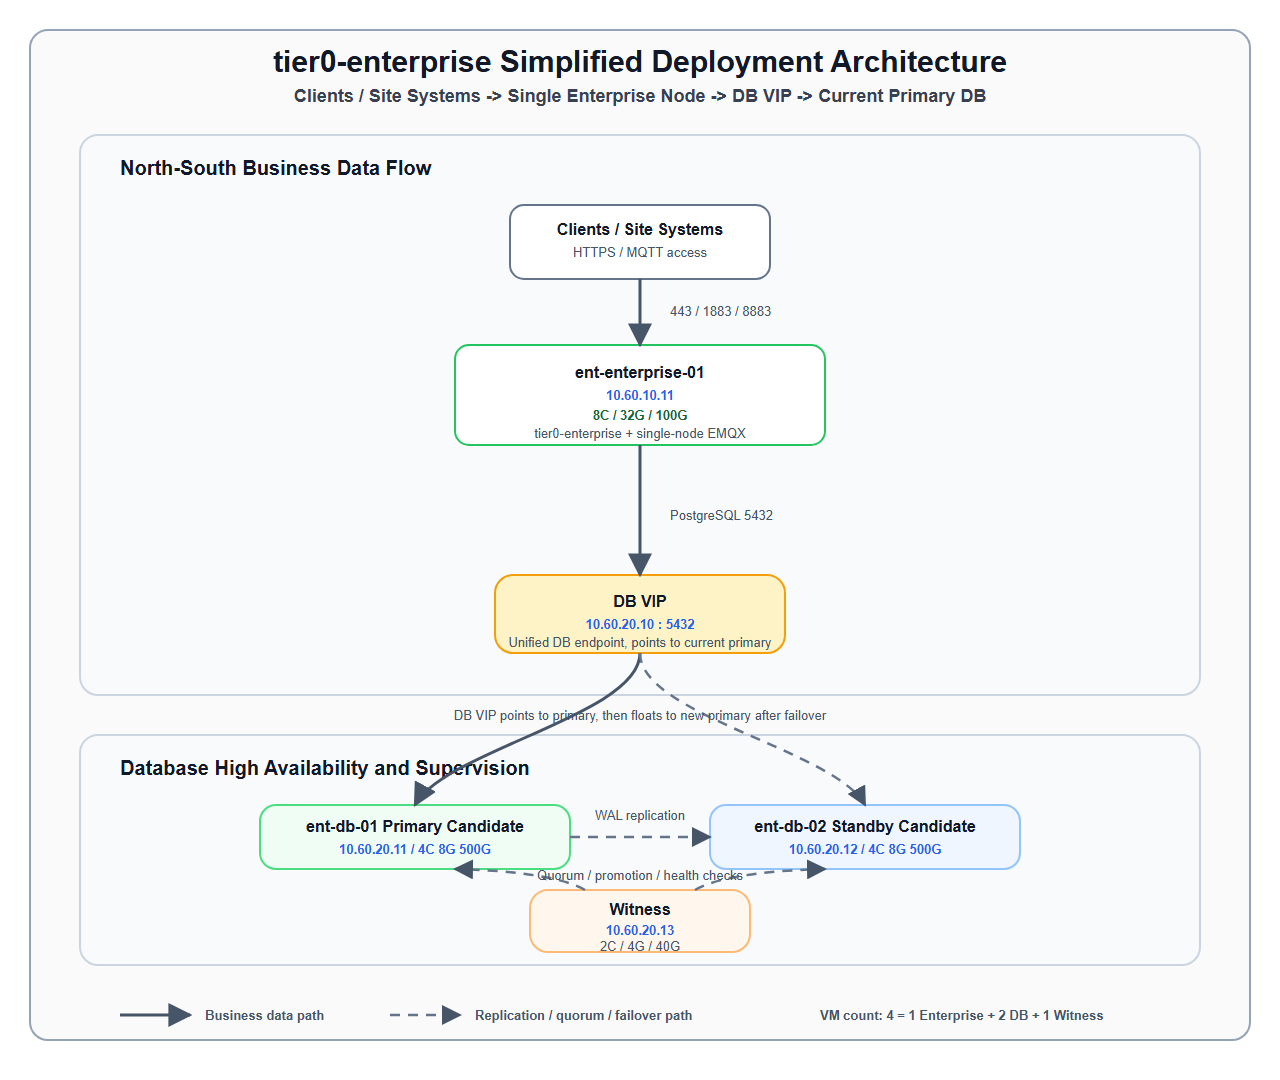
主要な経路:
- 業務経路:クライアント/現場システム →
ent-enterprise-01 → DB VIP → 現在のプライマリデータベース。
tier0-enterprise と EMQX は、どちらも ent-enterprise-01 上で実行します。- データベースへのアクセスには必ず
DB VIP を使用し、アプリケーションから ent-db-01/02 への直接アクセスは禁止します。
Witness はデータベースのクォーラム判定、昇格、健全性確認のみに参加し、業務経路には含まれません。
| フェーズ |
経路 |
説明 |
| 通常のアクセス |
ent-enterprise-01 -> DB VIP -> current primary |
アプリケーションは常に 10.60.20.10:5432 に接続します |
| 通常のレプリケーション |
current primary -> current standby |
PostgreSQL WAL ストリーミングレプリケーション |
| 通常の監視 |
DB-01/DB-02 -> Witness |
repmgrd が状態を報告し、Witness がクォーラム判定に参加します |
| プライマリ障害 |
standby -> Witness |
スタンバイがクォーラム確認を要求し、スプリットブレインを防止します |
| スタンバイの昇格 |
standby promote |
Witness の確認後にスタンバイを昇格させます |
| VIP の移動 |
DB VIP -> new primary |
10.60.20.10 を新しいプライマリに割り当てます |
| アプリケーションの復旧 |
ent-enterprise-01 -> DB VIP -> new primary |
接続プールの再接続後にアプリケーションが復旧します |
| ノード |
役割 |
vCPU |
メモリー |
ストレージ |
システムディスクの推奨構成 |
データディスクの推奨構成 |
主要コンポーネント |
ent-enterprise-01 |
単一の enterprise ノード |
8 |
32G |
100G |
単一の / システムディスク、100G |
個別のデータディスクなし |
tier0-enterprise、EMQX、任意で Nginx/HAProxy |
ent-db-01 |
PostgreSQL/TSDB のプライマリ候補 |
4 |
8G |
500G |
/ 80G |
/pgdata 360G、/pgwal 40G、/backup-staging 20G |
PostgreSQL、TimescaleDB、repmgr、keepalived |
ent-db-02 |
PostgreSQL/TSDB のスタンバイ候補 |
4 |
8G |
500G |
/ 80G |
/pgdata 360G、/pgwal 40G、/backup-staging 20G |
PostgreSQL、TimescaleDB、repmgr、keepalived |
ent-db-witness-01 |
Witness/クォーラム監視 |
2 |
4G |
40G |
/ 40G |
個別の割り当てなし |
repmgr witness、監視エージェント、監査ログ |
| 分類 |
台数 |
ノードごとの仕様 |
vCPU 小計 |
メモリー小計 |
ストレージ小計 |
| enterprise アプリケーションノード |
1 |
8C / 32G / 100G |
8C |
32G |
100G |
| PostgreSQL + TimescaleDB ノード |
2 |
4C / 8G / 500G |
8C |
16G |
1000G |
| Witness ノード |
1 |
2C / 4G / 40G |
2C |
4G |
40G |
| 合計 |
4 |
- |
18C |
52G |
1140G |
合計値:
- 仮想マシン:
4 台
- vCPU:
18
- メモリー:
52G
- ストレージ:
1.14T
| 対象 |
方法 |
ポート |
説明 |
| すべての仮想マシン |
ssh -i ~/.ssh/chen-rsa ops@<IP> |
22/TCP |
共通の鍵認証による SSH を実装後に使用します。それまでは現場のアカウントを使用します |
ent-enterprise-01 |
https://10.60.10.11 |
443/TCP |
業務用エンドポイント |
DB VIP |
psql -h 10.60.20.10 -p 5432 |
5432/TCP |
enterprise ノードと運用の許可リストのみ許可します |
| 接続元 |
接続先 |
ポート |
用途 |
| ユーザー/現場システム |
ent-enterprise-01 |
80/TCP |
HTTP 入口または HTTPS リダイレクト、任意 |
| ユーザー/現場システム |
ent-enterprise-01 |
443/TCP |
HTTPS の業務用入口 |
| デバイス/現場システム |
ent-enterprise-01 |
1883/TCP |
EMQX MQTT 平文通信、任意 |
| デバイス/現場システム |
ent-enterprise-01 |
8883/TCP |
EMQX MQTT TLS、推奨 |
| デバイス/現場システム |
ent-enterprise-01 |
8083/TCP |
MQTT WebSocket、任意 |
| デバイス/現場システム |
ent-enterprise-01 |
8084/TCP |
MQTT WebSocket TLS、任意 |
| 運用ネットワーク |
ent-enterprise-01 |
18083/TCP |
EMQX Dashboard、運用の許可リストのみ |
ent-enterprise-01 |
DB VIP |
5432/TCP |
PostgreSQL の業務アクセス |
| 接続元 |
接続先 |
ポート |
用途 |
ent-db-01 |
ent-db-02 |
5432/TCP |
PostgreSQL WAL ストリーミングレプリケーション |
ent-db-02 |
ent-db-01 |
5432/TCP |
復旧後の逆方向レプリケーション |
ent-db-01/02 |
ent-db-witness-01 |
5432/TCP |
repmgr メタデータ/Witness 通信 |
ent-db-01 |
ent-db-02 |
VRRP |
DB VIP の移動。プロトコル 112 を許可します |
- Docker Swarm はデプロイしません。
tier0-enterprise と EMQX を同一の ent-enterprise-01 ノードにデプロイします。ent-enterprise-01 はアプリケーション層の単一障害点です。障害時は手動で復旧するか、バックアップから再構築します。- このノードには
100G のシステムディスクが 1 台しかないため、業務データの長期保存には適しません。
tier0-enterprise の業務データは PostgreSQL/TimescaleDB に保存する必要があります。- アップロード、インポート/エクスポート、レポートのファイルはローカルに保存してバックアップできます。後で標準構成へ移行する場合は、これらのファイルを NFS/NAS またはオブジェクトストレージへ移行してください。
- 簡易構成の EMQX は、単一ノードのステートフルサービスです。
- データディレクトリを
ent-enterprise-01 上に固定します。例:/data/emqx。
- 設定、証明書、プラグイン、ルールエンジンの設定をバックアップします。
- メッセージ層の高可用性は提供しません。これが要件を満たさない場合は、3 ノードの EMQX クラスターを持つ標準構成を使用してください。
- PostgreSQL:
16 または現場で検証済みのバージョン。
- TimescaleDB:選択した PostgreSQL のメジャーバージョンと互換性のある安定版。
- レプリケーション:物理ストリーミングレプリケーション。
- フェイルオーバー:
repmgrd + witness。
- データベースの入口:
DB VIP。
- 接続プール:
ent-enterprise-01 上で PgBouncer を実行し、データベースへの接続負荷を低減できます。
- Witness は
repmgr witness のメタデータと監視ロジックのみを保持します。
- Witness は業務 SQL を処理しません。
- Witness の障害で現在のプライマリは停止しませんが、自動フェイルオーバーの信頼性は低下します。
| ポート/プロトコル |
許可範囲 |
用途 |
22/TCP |
運用ネットワークから 4 台の仮想マシン |
SSH |
80/TCP |
ユーザーネットワークから ent-enterprise-01 |
HTTP リダイレクトまたは内部の平文通信入口 |
443/TCP |
ユーザーネットワークから ent-enterprise-01 |
HTTPS の業務用入口 |
1883/TCP |
デバイス/現場システムから ent-enterprise-01 |
EMQX MQTT 平文通信、任意 |
8883/TCP |
デバイス/現場システムから ent-enterprise-01 |
EMQX MQTT TLS、推奨 |
8083/TCP |
デバイス/現場システムから ent-enterprise-01 |
EMQX WebSocket、任意 |
8084/TCP |
デバイス/現場システムから ent-enterprise-01 |
EMQX WebSocket TLS、任意 |
18083/TCP |
運用ネットワークから ent-enterprise-01 |
EMQX Dashboard、許可リストのみ |
5432/TCP |
enterprise から DB VIP、DB/Witness 内部 |
PostgreSQL/repmgr |
112/VRRP |
データベースノード間 |
DB VIP の移動 |
9100/TCP |
監視システムから 4 台の仮想マシン |
node exporter、任意 |
| 障害シナリオ |
想定される動作 |
業務への影響 |
ent-enterprise-01 の障害 |
アプリケーションと EMQX が停止し、手動復旧またはバックアップからの再構築が必要です |
アプリケーション層が全面停止します |
| 現在の DB プライマリの障害 |
Witness のクォーラム確認後にスタンバイが昇格し、DB VIP が移動します |
数秒から数分の書き込み中断。アプリケーションの再接続が必要です |
| DB スタンバイの障害 |
プライマリは稼働を継続し、レプリケーションのアラートが発生します |
直接の業務停止はありませんが、DB のホットスタンバイを失います |
| Witness の障害 |
現在のプライマリは稼働を継続しますが、自動フェイルオーバーの信頼性が低下します |
直接の業務停止はありません。Witness を優先して復旧します |
| DB VIP の移動失敗 |
新しいプライマリが存在しても、共通の入口に到達できない場合があります |
業務が停止します。VIP の手動割り当てが必要です |
| 確認項目 |
合格基準 |
| 4 台の仮想マシンのホスト名が固定されている |
hostnamectl が計画と一致します |
| 共通の SSH 接続が利用できる |
運用端末から鍵認証で 4 台すべてにアクセスできます |
| 時刻同期 |
4 台間の時刻差が 1s 未満です |
| ファイアウォールが許可されている |
第 9 節のポートが定められた範囲で許可されています |
| enterprise サービスが正常である |
tier0-enterprise のヘルスチェックに合格します |
| EMQX の状態が検証されている |
EMQX ノード、待ち受けポート、永続化ディレクトリが正常です |
| enterprise のディスク使用率が安全な範囲にある |
/ の使用率が 70% 未満で、ログとキャッシュのクリーンアップが設定されています |
| DB のプライマリ/スタンバイが正常である |
repmgr cluster show でプライマリ、スタンバイ、Witness が正常です |
| DB VIP が利用できる |
enterprise ノードから 10.60.20.10:5432 に接続できます |
| DB プライマリのフェイルオーバー訓練 |
スタンバイの昇格と DB VIP の移動ができます |
| バックアップのリストア訓練 |
テスト用データベースへバックアップをリストアできます |
- 4 台の仮想マシンを作成し、ホスト名、IP、時刻同期、SSH を設定します。
- OS の基本設定、ファイアウォール、マウント、カーネルパラメーターを初期化します。
ent-enterprise-01 に tier0-enterprise をデプロイします。ent-enterprise-01 に単一ノードの EMQX をデプロイします。- PostgreSQL + TimescaleDB のプライマリ/スタンバイをデプロイします。
- repmgr witness、repmgrd、DB VIP 移動スクリプトをデプロイします。
- 接続、EMQX の復旧、データベースのフェイルオーバー、バックアップのリストア、日常点検を検証します。
- 運用 Runbook、認証情報の保管、日常点検タスクを整備します。
- 簡易構成にはアプリケーション層の単一障害点があります。
ent-enterprise-01 が停止すると、業務サービス全体が利用できなくなります。
- EMQX は単一ノードであり、メッセージ層の高可用性を提供しません。
ent-enterprise-01 のシステムディスクは 100G の 1 台のみです。ログ、キャッシュ、添付ファイル、一時ファイルの使用量を管理する必要があります。- 後でアプリケーション層または EMQX の高可用性が必要になった場合は、標準構成へ移行します。
- データベースの RPO/RTO は未確定です。このプライマリ/スタンバイ構成はデータ損失ゼロを保証しません。
- DB VIP 移動スクリプトは現場での検証が必要です。特に、仮想化/ネットワーク基盤が VRRP を許可していることを確認してください。

